绩效评估依据半年的 1:1 会议,而不是最近两周
公平的半年评估需要完整的半年,而你的 1:1 已经保存了它。如果每一次 1:1 都在 Speak-Y 中录制并带有此人的标签,通过 MCP 连接的 AI 助手就能把它们全部读完—— 比如 4 月到 9 月的 24 次会议——列出对方提出了什么、你们约定了什么、每项约定 后来怎样了,并在每一行后面注明日期。这份清单就是事实依据。判断、评级和绩效 评估的文字仍由你来写。
本指南跟随一个案例:一位经理为 Anna 撰写 2026 年 4 月 1 日至 9 月 30 日的 评估,Anna 是一名工程师,每周与经理开一次 30 分钟的 1:1。本文以 一对一会议记录 中的 1:1 习惯为前提,展示一次 读取半年记录时会有什么不同。产品细节已于 2026 年 10 月 17 日对照 macOS 应用和 各服务商的文档核实。
为什么评估总会偏向最近两周?
因为记忆是按日期加权的。Anna 在 9 月处理的那次故障历历在目;她在 4 月提出的 迁移方案却想不起来,除非有什么提醒你。绩效管理研究把这称为近因偏差,而常见的 建议——全年做笔记——之所以行不通,原因和 1:1 笔记一样:没有人能坚持记下来。
录下来的 1:1 就是你不必亲手写的笔记。Speak-Y 中的每一条都有按发言人划分的 转写、以行动项开头的 AI 摘要,以及你在达成共识时用 ⌥1 标记的时刻。 二十四条记录太多了,评估前不可能逐一重读。但对助手来说并不多——只要它读的是 全部,而不只是最新的几条。
评估季之前需要准备好什么?
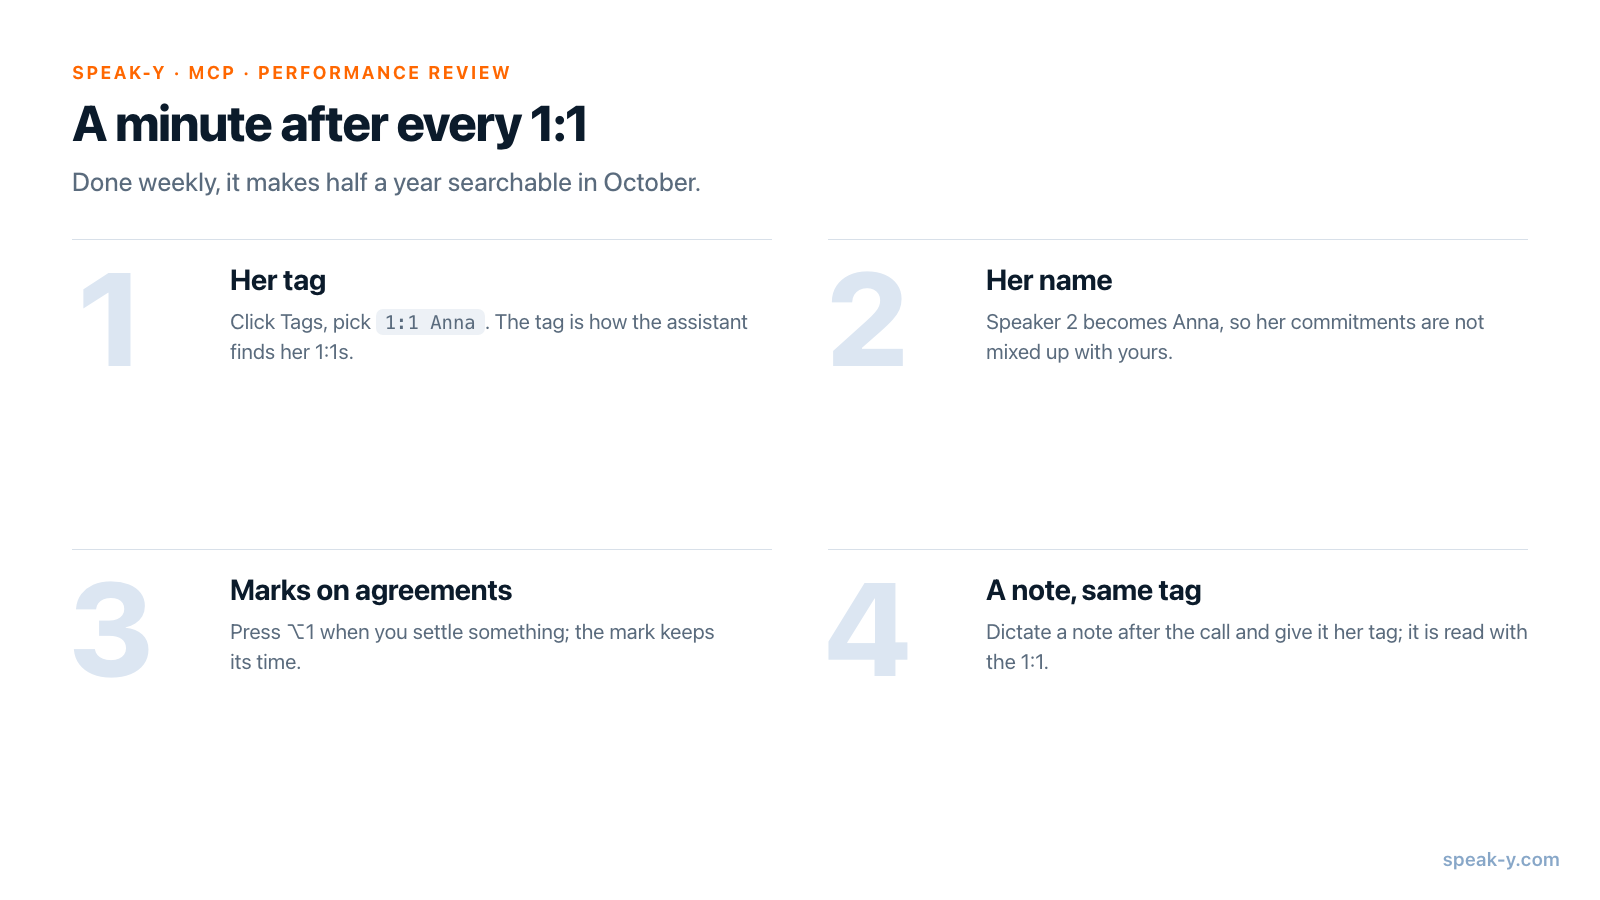
功夫花在这半年里,每次 1:1 一分钟。三个习惯决定了之后能否把事实收集起来:
- 每人一个标签,每次 1:1 结束后立即打上:在记录中点击 标签,选择 1:1 Anna。助手正是靠这个标签找到她的 1:1;一场名为“会议”、没人打过 标签的通话,对它来说是看不见的。
- 她的发言人写上她的名字。 点击 Speaker 2,输入
Anna。否则 “计费迁移我来负责”这句话就不属于任何人,助手也分不清她的承诺和你的承诺。 - 在约定处做标记。 一旦敲定某件事,就按 ⌥1。标记保留时间点,助手会 连同转写一起读取,所以在半小时的谈话中很容易找到约定。
给自己的备忘同样有用:通话后用听写记下来,并给这条听写打上同样的标签。 它会紧挨着这次 1:1,并和它一起被读取。
如何要求事实,而不是结论?
一次性连接 Claude、ChatGPT、Cursor 或其他 MCP 客户端:在 集成页面 (账户菜单 → 连接 AI 助手)点击 连接,也可以从 设置 → 集成 进入。 把会议记录连接到 AI 助手 一文有详细步骤。Speak-Y 的 MCP 服务器包含在所有套餐中,Free 也不例外,并在你的 Mac 上本地读取录音。
然后要求带日期的事实,并说明哪些事不要做:
根据我带有“1:1 Anna”标签的 1:1,为 Anna 的半年评估收集事实,
时间段为 2026 年 4 月 1 日至 9 月 30 日。
读取这个时间段内的每一条记录,而不只是最新的几条。
列出:她提出的话题(及频率)、约定以及每项约定的结果、
我做出的承诺以及我是否跟进。
每一行后面注明 1:1 的日期。不要评级,不要用形容词
描述她的性格,不要与任何人比较。
这个请求里有两处细节真正起作用:
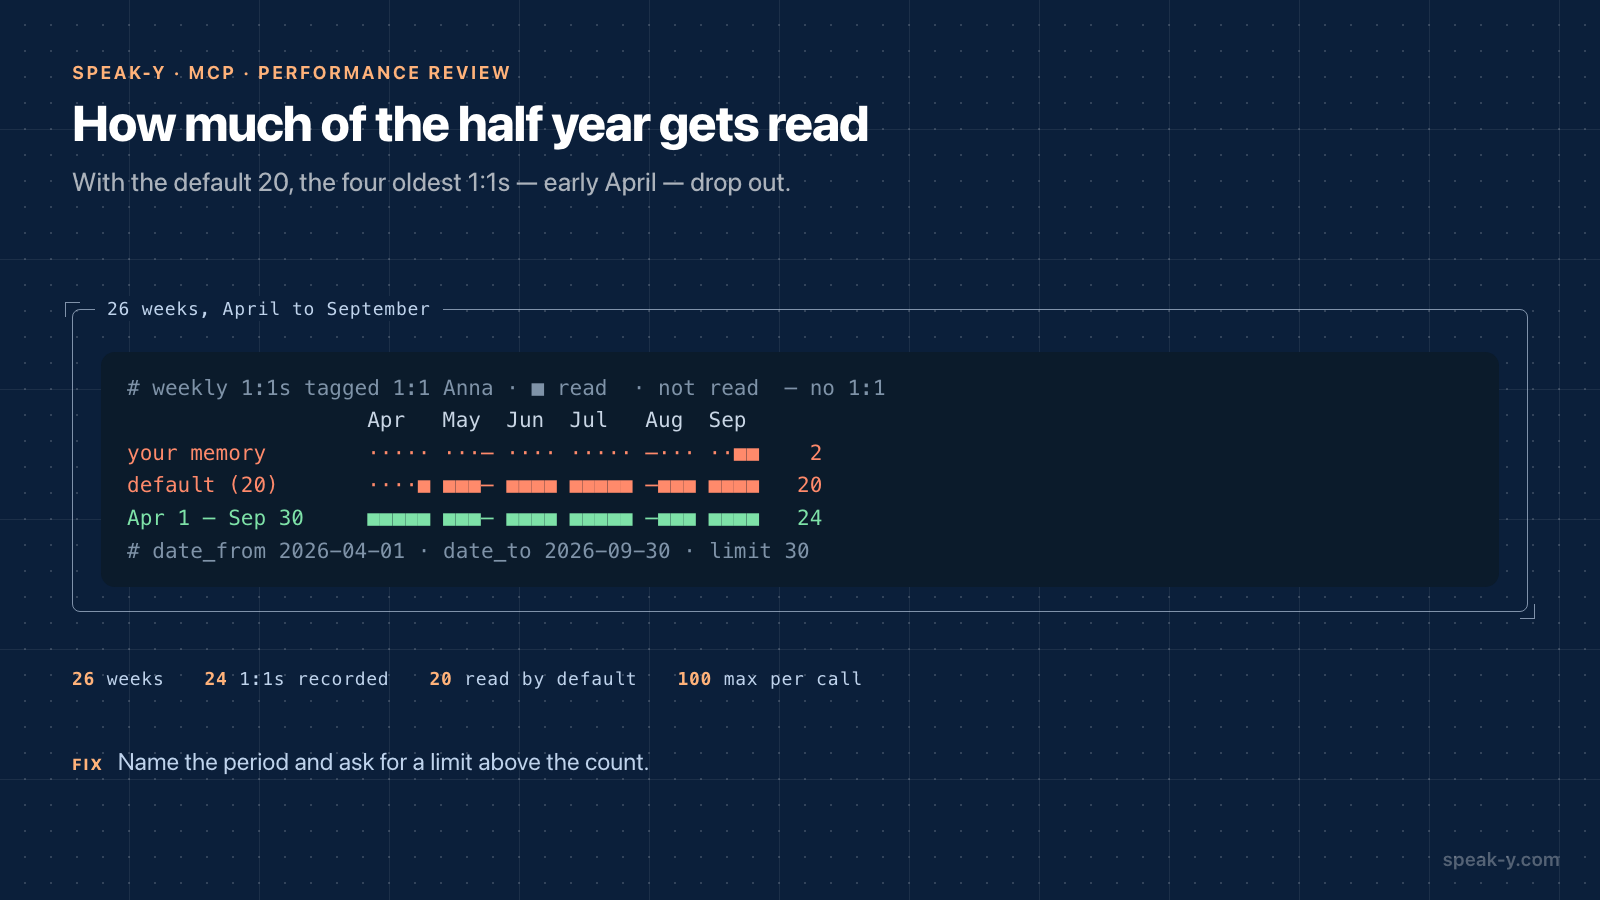
- 时间段。
list_recordings默认返回最新的 20 条记录。每周一次的 1:1 共 24 条,按默认值会漏掉最早的 4 条——整个 4 月上旬,包括 Anna 第一次提到 值班负担的那次。这又是近因偏差,只不过这次发生在工具调用里。写明时间段后, 助手会传入date_from和date_to,以及大于记录数的limit;该工具每次 调用最多接受 100。 - 先读摘要。 二十四份半小时的转写,对一次对话来说文字量很大。让助手先读
每次 1:1 的摘要和标记,只有需要引用某一行时才打开完整转写。
get_transcript的summary格式正是为此准备的。
事实清单是什么样的?
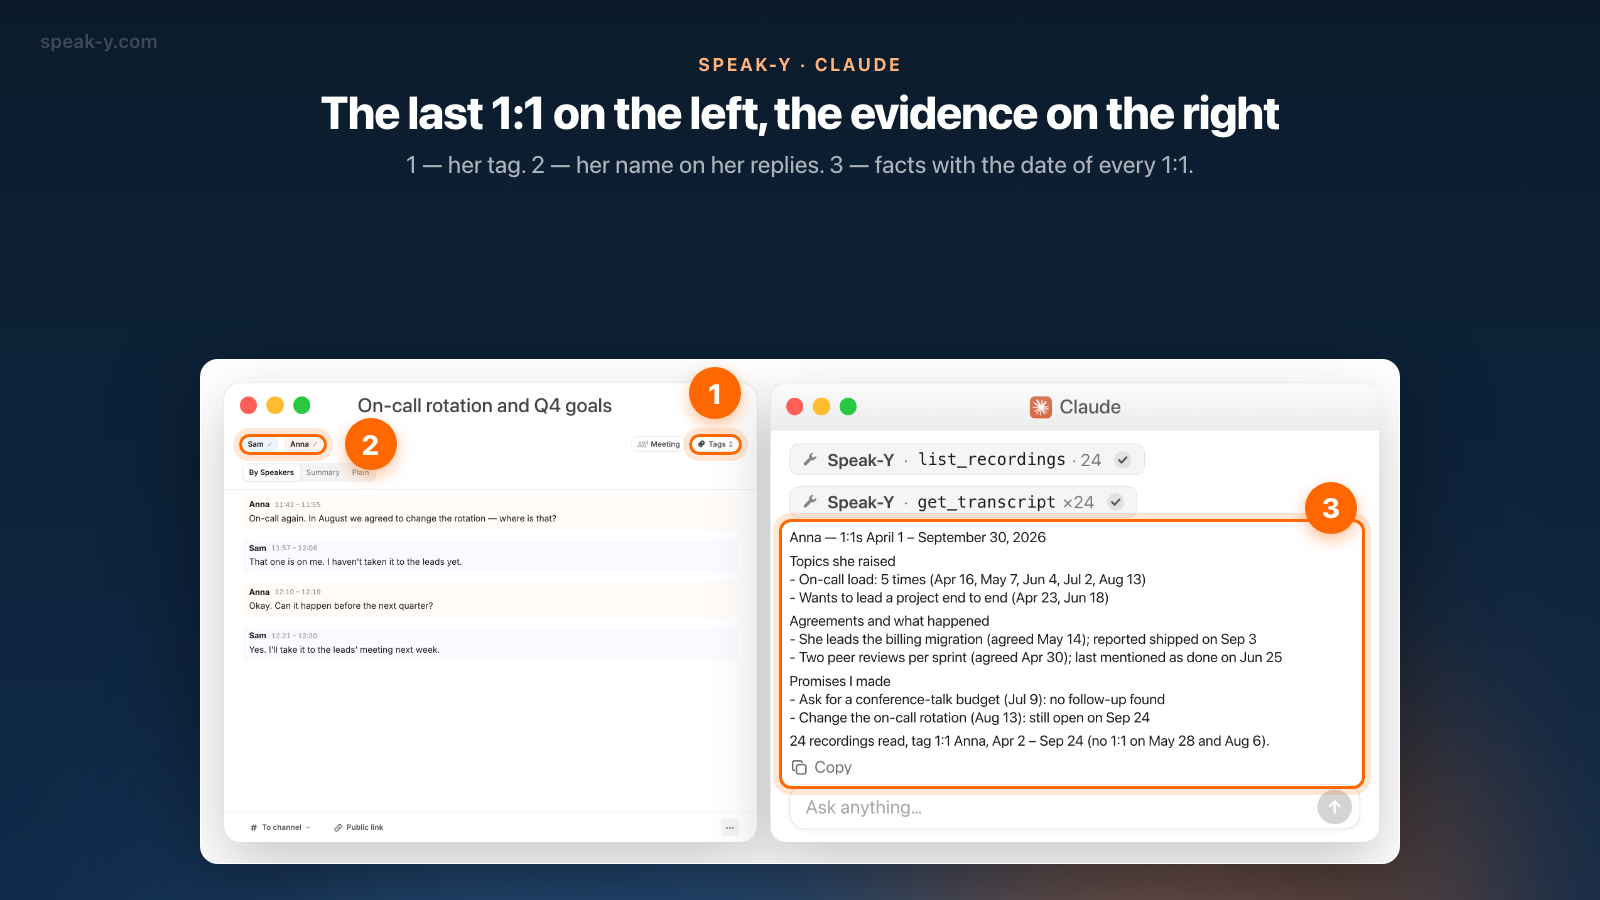
对 Anna 来说,回答是这样的:
Anna — 1:1,2026 年 4 月 1 日至 9 月 30 日
她提出的话题
- 值班负担:5 次(4 月 16 日、5 月 7 日、6 月 4 日、7 月 2 日、8 月 13 日)
- 希望从头到尾主导一个项目(4 月 23 日、6 月 18 日)
约定及结果
- 由她主导计费迁移(5 月 14 日约定);
  9 月 3 日报告已上线
- 每个迭代做两次同事评审(4 月 30 日约定);
  最后一次提到已完成是 6 月 25 日
我做出的承诺
- 申请会议演讲预算(7 月 9 日):未找到后续
- 调整值班轮换(8 月 13 日):截至 9 月 24 日仍未落实
共读取 24 条记录,标签 1:1 Anna,4 月 2 日至 9 月 24 日
(5 月 28 日和 8 月 6 日没有 1:1)。
把它当作地图来读,而不是草稿。每一行都指向一次你可以打开的 1:1,最后一行 说明这份清单以什么为依据。其中有两条关乎的是你,而不是 Anna:你自己的两项 承诺都没有下文。如果评估里五次提到值班负担,却不提调整轮换本该由你来做, 那就不公平了。
“9 月 3 日报告已上线”的意思是 Anna 在 1:1 中这样说过。Speak-Y 不跟踪行动项 是否完成;“结果”是助手对之后几次 1:1 的解读。在把某一行写进评估之前,先打开 那次 1:1,在 按说话人 标签页或 摘要 中读一读她的回答。
在评估中,助手不该做什么?
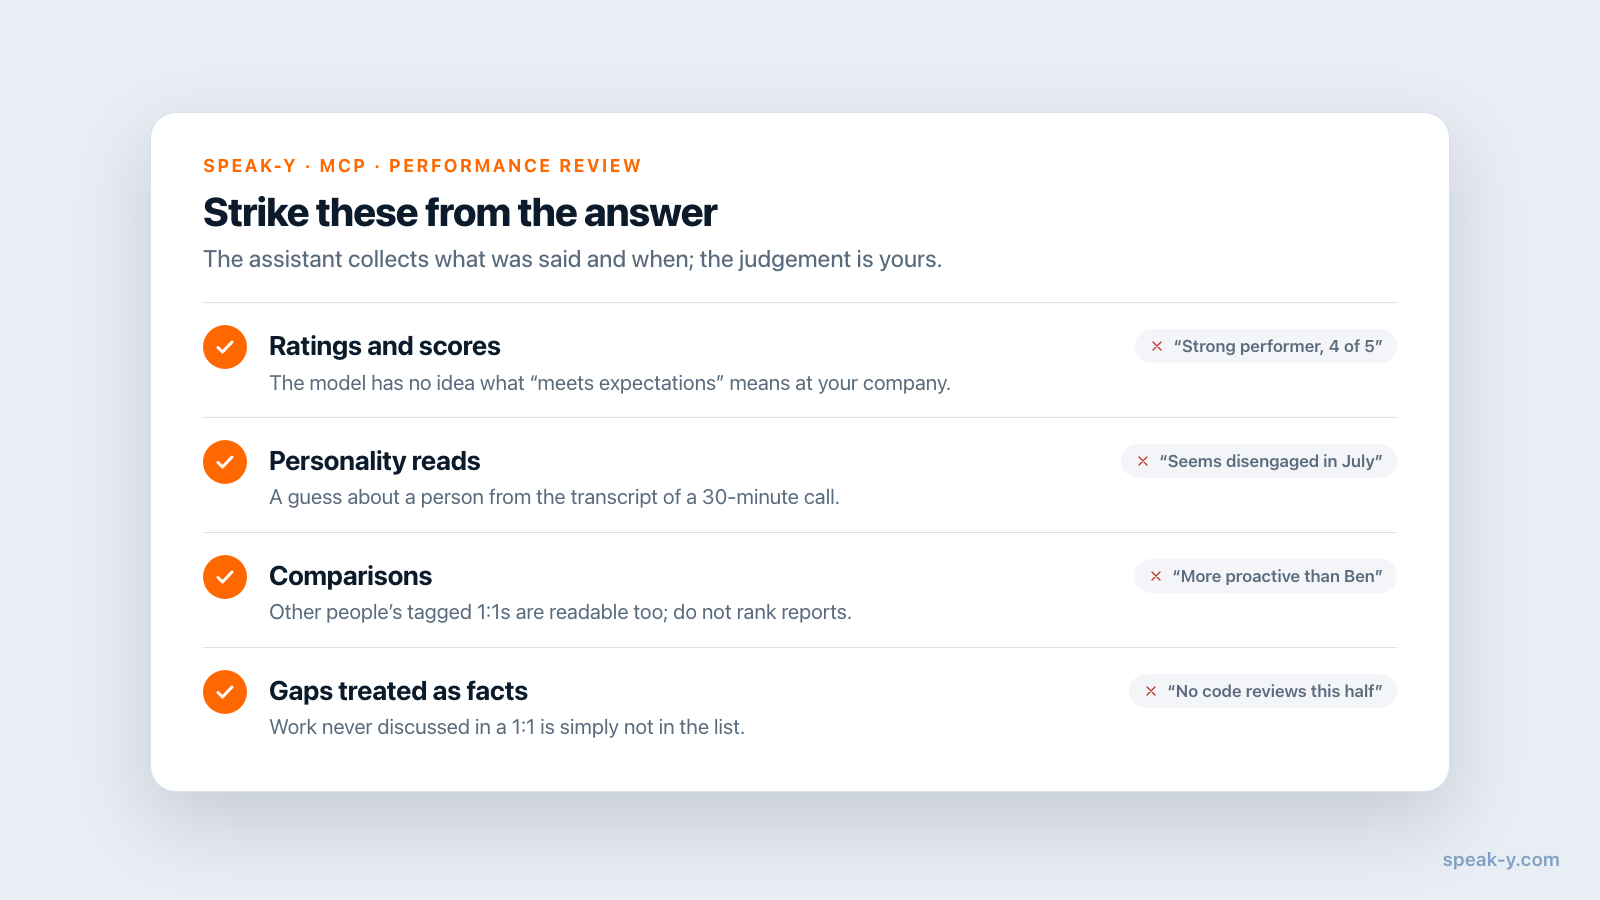
凡是把事实变成判断的事都不该做。上面的请求已经排除了这些,但仍值得检查一下 回答:
- 评级和打分。 读过 24 份摘要的模型,并不知道在你的公司“符合预期”意味着 什么。
- 对性格的解读。 “7 月看起来不太投入”是根据一次 30 分钟通话的转写对一个人 的猜测。删掉。
- 比较。 如果别人的 1:1 也打了标签,助手同样能读取;不要让它给下属排名。
- 把空白当作事实。 没在 1:1 中讨论过的工作,不会出现在清单里。代码评审、 故障处理频道和同事反馈都在别处。
还有监管方面的原因。欧盟《人工智能法》(AI Act)将用于“监控和评估”劳动者 “绩效和行为”的 AI 系统列为高风险(附件三,第 4 点 (b));在 2026 年的 Digital Omnibus 之后,这些义务自 2027 年 12 月 2 日起适用。某一具体做法是否 落入其中,应由你的法务团队判断。无论如何,稳妥的模式都一样:助手负责收集, 人来评估。
谁能看到 1:1,Anna 应该知道吗?
在 Speak-Y 中,1:1 录音是私人的:除非你点击 To channel 把它发布到团队 频道,否则只有你能看到,而 1:1 本就不该出现在频道里。MCP 服务器在你的 Mac 上 读取录音,不需要为此上传任何内容。不过,助手读到的内容会成为你与其服务商模型 之间对话的一部分——这和使用任何 AI 写作工具时的决定一样,而对评估来说,这是 关于员工的个人数据。本地 MCP 与云端 MCP 具体说明了文字会去往哪里。
Anna 应该知道。Speak-Y 录音时不会有机器人加入通话,所以没有人会自动收到通知; 在评估周期开始时说明 1:1 会被录音,供你们双方记录之用,并核对公司政策以及你 所在地的会议录音相关法律。事实清单最 公平的用法,是在评估谈话之前给 Anna 一份副本:她会看到同样的日期,也可以补充 1:1 中没有谈到的内容。
什么时候绩效管理工具更合适?
当评估本身就在那个工具里进行时。例如,Lattice 于 2026 年 7 月 15 日宣布推出 基于事实的评估草稿,依据的是保存在 Lattice 中的 1:1、反馈、目标和进展更新; 自 2026 年 6 月起,它的 AI 智能体可以加入 Zoom、Google Meet 和 Microsoft Teams 上的 1:1 做笔记,Lattice 客户无需额外付费。如果你的公司在那里 做评估,这条路能让事实紧挨着评估表、校准流程和 HR 流程。
本指南的做法适合这样的经理:1:1 在 Mac 上录制、没有机器人加入,公司没有这类 工具或用的是别的工具,并且希望在动笔之前先以自己的格式拿到事实。同样的习惯每周 也有回报——下次 1:1 前的简报 也来自同样带标签的录音——而对整个团队都重要的约定,应当放在 Speak-Y Teams 那边的共享频道里,而不是 1:1 中。
FAQ
AI 助手能根据 1:1 记录帮我写绩效评估吗?
能,但它是调研员而不是评判者。如果你的 1:1 在 Speak-Y 中录制并带有此人的标签,且已连接 Claude、ChatGPT 或 Cursor 等 MCP 客户端,助手就能读取评估期内的每一次 1:1,列出话题、约定以及它们后来的结果,每一条都附上会议日期。评级和评估的措辞仍由你决定。
为什么助手只读了半年中的一部分?
因为除非要求更多,list_recordings 只返回最新的 20 条记录。半年的每周 1:1 有 24 到 26 条,最早的几周会被悄无声息地漏掉。请在请求中写明时间段(4 月 1 日至 9 月 30 日),并要求 limit 大于记录数;该工具每次调用最多接受 100。
员工应该知道我们的 1:1 被录音并用于评估吗?
应该。Speak-Y 录音时不会有机器人加入,所以通话中没有人会自动收到通知。在评估周期开始时告诉对方:1:1 会被录音,供你们双方记录之用,并核对公司政策和当地法律。在评估谈话之前把事实清单分享给对方,是最公平的用法。
谁能看到我在 Speak-Y 中的 1:1 录音?
只有你自己,除非你点击 To channel 把某条发布到团队频道;1:1 应当保持私人。助手从你的 Mac 本地读取录音,但它的模型运行在服务商的云端,所以它读到的内容会成为那次对话的一部分。
这需要 Speak-Y 的付费套餐吗?
助手不需要:MCP 服务器包含在所有套餐中,Free 也不例外。限制在于录音:截至 2026 年 10 月 17 日,Free 单场会议最长 30 分钟、每月共 2 小时,Pro 单场最长 60 分钟、每月 10 小时。与四个人每周各开一次 30 分钟的 1:1,每月约 9 小时,Pro 就够用。